Румынские Ș, Ț и знаки под буквами: как проверить шрифт и текст
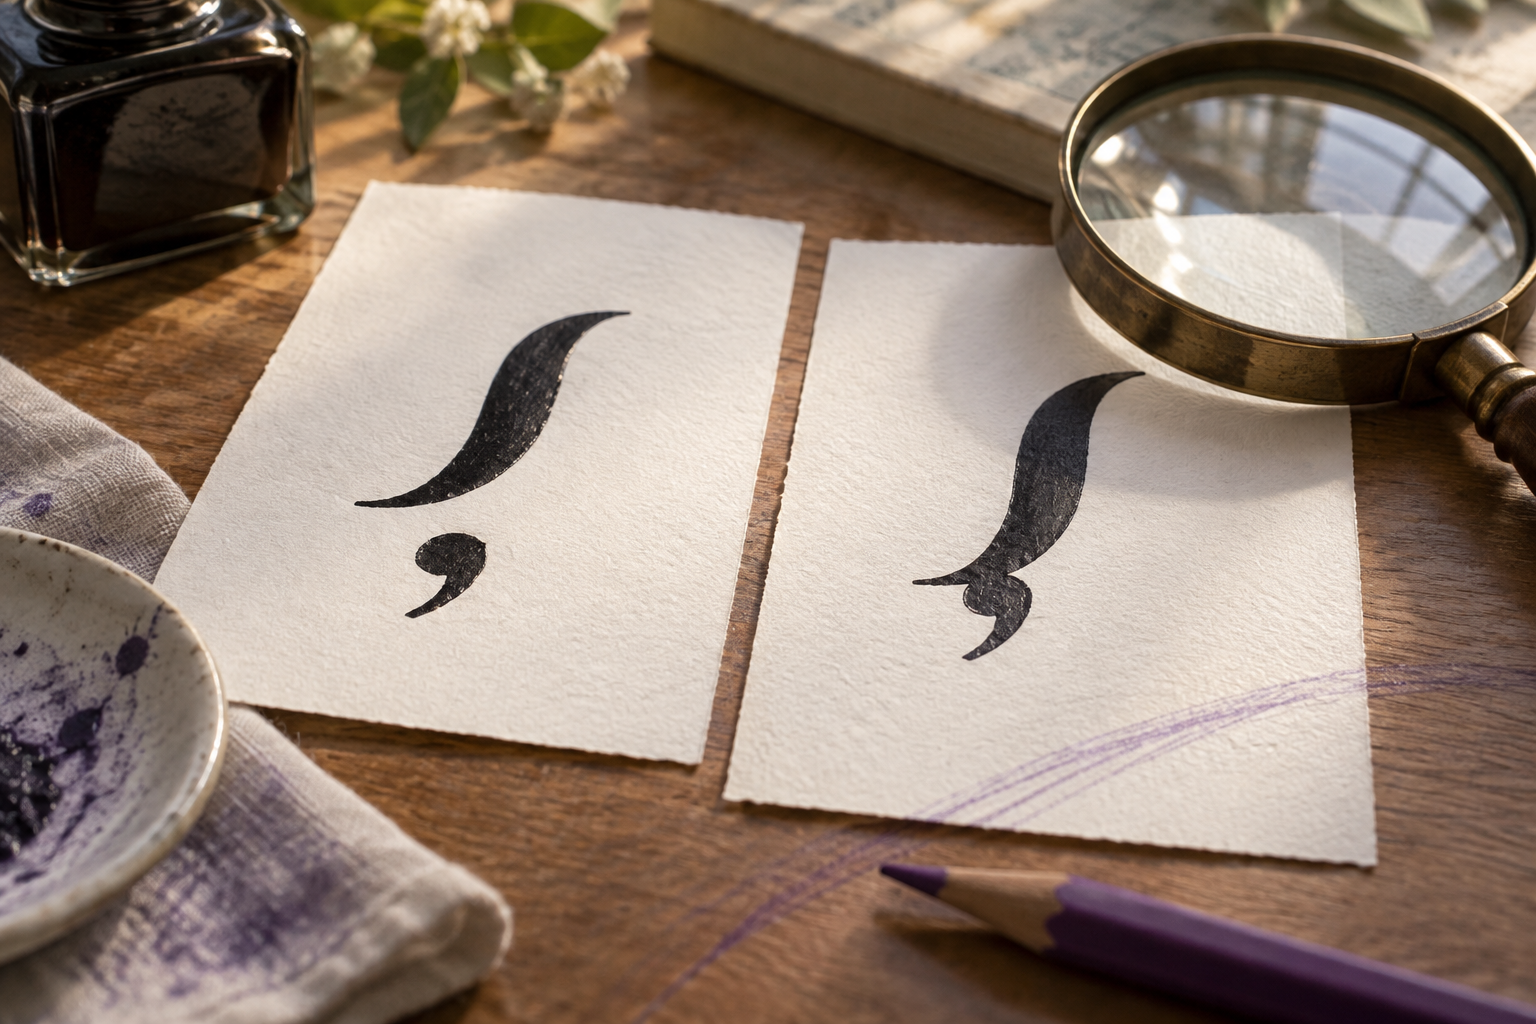
В румынском тексте буквы Ș/ș и Ț/ț несут собственные звуки и должны оставаться различимыми во всём наборе: в строчных и прописных формах, после копирования, при экспорте и на странице. Главная ловушка — похожие буквы с седилью: в старых данных они могли обозначать румынскую запятую снизу, хотя в Unicode у них отдельные коды и назначения. Проверяйте не только рисунок, но и сам текст.
Почему румынские знаки снизу легко перепутать
В румынском используются четыре буквы с запятой под основой: Ș, ș, Ț и ț. Их внешняя деталь располагается снизу, но это не просто декоративная вариация седили. Например, румынская строчная ș с запятой снизу отличается и от турецкой ş с седилью, и от обычной s. В наборе эти различия отвечают за правильное написание слов, поэтому шрифт должен показывать запятую явно, а текст — содержать подходящие символы.
Сходство кодов создаёт практическую проблему. В Unicode для румынских букв с запятой снизу предусмотрены U+0218 Ș, U+0219 ș, U+021A Ț и U+021B ț. У букв с седилью другие кодовые точки: U+015E Ş, U+015F ş, U+0162 Ţ и U+0163 ţ. В документации Unicode отдельно описана путаница, возникшая в старых наборах символов: один знак исторически использовали для нескольких визуально похожих форм. Для нового румынского текста следует различать запятую снизу и седиль, а при разборе старых данных учитывать возможную неоднозначность (Unicode Core Specification, раздел о запятой и седиле).
Начните с того, какие данные должен поддерживать шрифт
До рисования или проверки составьте короткий список ожидаемых текстов. Для обычных румынских фраз включите слова с ș и ț, заглавные буквы в заголовках или именах, а также прописные версии Ș и Ț. Если шрифт будет применяться вместе с турецким или в старых архивах, добавьте отдельно Ş/ş и Ţ/ţ. Это поможет не принять одну форму за другую и понять, где нужна языковая поддержка, а где — совместимость с полученными данными.
Полезно разделить задачу на три уровня:
- Символ есть в файле. Для каждого знака назначена отдельная кодовая точка и глиф; наборщик не подменяет его пустым прямоугольником или символом из другой гарнитуры.
- Форма соответствует языку. У румынских букв видна запятая снизу, а у символов с седилью — характерная форма седили. В маленьком размере отметка не должна сливаться с основой.
- Текст переживает рабочий маршрут. Символ не меняется при вставке, сохранении, экспорте макета, загрузке на сайт или повторном открытии файла.
Эти проверки отвечают на разные вопросы. Один красивый пример слова не доказывает, что в шрифте есть все четыре прописные и строчные формы. А наличие кодовой точки не гарантирует, что глиф хорошо нарисован, правильно привязан к метрикам и останется читаемым в конкретном кегле.
Составьте тестовый набор без случайных подмен
Возьмите по одному короткому слову или сочетанию для каждой нужной буквы. В тесте должны отдельно встречаться Ș, ș, Ț и ț, а рядом — обычные S/s и T/t. Если проверяется соседство с турецким, добавьте Ş/ş и Ţ/ţ. Не ограничивайтесь демонстрационной строкой ȘșȚț: она показывает наличие знаков, но почти ничего не говорит о ритме слова, интервалах или заметности нижних отметок.
Для проверки соседства удобно использовать три типа фрагментов: короткое слово с одной целевой буквой, слово с несколькими знаками и смешанный фрагмент, где рядом стоят S/T и румынские буквы. Сравните строчные и прописные версии в одной строке, затем повторите сравнение на более мелком кегле. Внизу отметки легко теряются у тесной строки или попадают в межстрочный интервал — это видно в контексте лучше, чем в таблице глифов.
Добавьте к образцу контрастную пару, например румынскую ș рядом с турецкой ş. Увеличьте фрагмент настолько, чтобы различить характер нижнего знака, а затем уменьшите до размера реального макета. Если две формы почти одинаковы, проверьте, не использует ли шрифт одну и ту же конструкцию или не подменился ли символ. Важно сохранять правильные кодовые точки: при ручном наборе легко вставить знакомый знак из другой раскладки и не заметить это по внешнему виду.
Проверьте составные и разложенные варианты
В текстовых данных румынская буква может быть представлена готовым символом либо базовой латинской буквой вместе с комбинируемым знаком снизу. Например, ș может прийти как U+0219 или как s плюс U+0326 COMBINING COMMA BELOW. Аналогично, ț может быть U+021B или t плюс U+0326. Это важно при копировании из разных редакторов, импорте архивов и работе с преобразованием текста.
Создайте тестовую строку с обоими представлениями каждой нужной буквы. При сравнении не ждите, что последовательности будут побайтно одинаковы: они имеют разное устройство, но могут обозначать канонически эквивалентный текст после нормализации. Unicode описывает NFC и NFD как формы нормализации; NFC обычно удобна для хранения общего текста, а NFD раскладывает некоторые знаки на основу и диакритический элемент (FAQ Unicode о нормализации, UAX #15).
Составной вариант проверяет глиф готовой буквы. Разложенный вариант проверяет сочетание базовой буквы и комбинируемой запятой: позиционирование отметки, высоту строки и поведение движка текста. Если готовый знак выглядит верно, а разложенный уходит слишком далеко вниз, касается соседней строки или оказывается сбоку, проблема может быть в метриках и обработке комбинируемого знака. Отдельно осмотрите результат после копирования в целевой редактор: его движок, резервные шрифты и правила нормализации могут изменить отображение.
Не смешивайте нормализацию с визуальной заменой. NFC не превращает автоматически румынскую запятую в седиль, а похожие буквы Ş и Ș остаются разными символами. Unicode указывает, что исторически в румынских данных встречались варианты U+015F и старые кодировки с неоднозначным смыслом. Если нужно читать такой архив, это задача осознанного преобразования данных, а не повод считать все похожие нижние знаки взаимозаменяемыми.
Посмотрите на глиф в реальном размере и в строке
Сначала оцените знак отдельно, увеличив его: запятая должна быть направлена и отделена так, чтобы не восприниматься как точка, хвост буквы или случайный дефект сканирования. Затем вернитесь к обычному масштабу. Небольшой знак может быть ясным в увеличении, но исчезать в тексте, если он слишком тонкий, слишком близок к основанию или недостаточно отличается от седили.
Сравните толщину нижнего элемента с основными штрихами буквы. В рукописном шрифте не нужно механически делать запятую такой же толщины, как вертикаль, но она должна восприниматься как часть той же руки. Проверяйте пропорции в паре строчная/прописная: у Ș и Ț отметка может выглядеть иначе из-за ширины и формы основания. Не копируйте знак из одной буквы в другую автоматически, если после этого он становится слишком тесным или смещённым.
После изолированного осмотра проверьте слово, строку и абзац. Обратите внимание на нижний запас: хвосты букв предыдущей строки и запятые снизу не должны сталкиваться. В заголовке или карточке текста строчные буквы могут стоять близко к нижнему краю блока; там стоит проверить реальную высоту строки и обрезку контейнера. Если тестовый текст будет печататься, распечатайте небольшой фрагмент в предполагаемом масштабе — экранное сглаживание иногда скрывает тонкую отметку.
Чек-лист перед передачей файла
- ☐ В списке символов есть U+0218, U+0219, U+021A и U+021B, если нужен полный румынский набор.
- ☐ Ș/ș и Ț/ț показывают запятую снизу и не сливаются с основой.
- ☐ Турецкие Ş/ş и Ţ/ţ проверены отдельно, если встречаются в материалах.
- ☐ В тесте присутствуют прописные, строчные формы и обычные S/s, T/t.
- ☐ Готовые символы проверены рядом с их разложенными сочетаниями с U+0326.
- ☐ Текст протестирован в редакторе, где он будет набираться или публиковаться.
- ☐ Нет пустых квадратов, подмены отдельной гарнитурой, обрезанных знаков и столкновений с соседней строкой.
- ☐ Сохранён исходный текст теста, чтобы повторить проверку после изменения шрифта.
Частые ошибки
Считать Ş/ş эквивалентом Ș/ș по рисунку. В обычном размере они могут казаться почти одинаковыми. Сверяйте кодовые точки и делайте увеличенную пробу: седиль и comma below имеют разные названия и назначения, даже если конкретная гарнитура рисует их похоже.
Проверить только строчную форму. В меню, географическом названии или заголовке текст может перейти в прописные. Добавьте Ș и Ț в тест и посмотрите на форму отметки у более широких оснований.
Считать, что одного кодового покрытия достаточно. Код может присутствовать, но глиф быть пустым, плохо выровненным или слишком мелким. Проверяйте реальные слова, размер и межстрочное расстояние.
Удалить комбинируемую запятую как «лишний символ». При разложенном представлении U+0326 — часть буквы. Удаление отметки меняет отображение и может испортить текст. Сначала определите, где возникла проблема: в кодировке, нормализации, шрифте или редакторе.
Исправлять старый текст заменой всех похожих знаков. У массовой замены может быть побочный эффект на турецкий текст или на специальные имена. Сохраняйте копию, выясняйте источник и применяйте языковую конверсию только к известному румынскому материалу.
Часто задаваемые вопросы
Чем румынская ș отличается от турецкой ş?
В Unicode это разные символы. Румынская ș — U+0219 LATIN SMALL LETTER S WITH COMMA BELOW; турецкая ş — U+015F LATIN SMALL LETTER S WITH CEDILLA. Внимательно сравните нижнюю отметку в увеличении и сохраните исходный символ при наборе.
Какие четыре символа нужны для румынских знаков снизу?
Проверьте прописные Ș и Ț, а также строчные ș и ț: U+0218, U+021A, U+0219 и U+021B соответственно. Если тексты бывают смешанными, добавьте турецкие Ş/ş и Ţ/ţ отдельными тестовыми символами.
Почему один и тот же текст отображается иначе после копирования?
Буква могла попасть в виде готового символа или как основа с комбинируемым знаком. Кроме того, некоторые редакторы нормализуют строки, а при отсутствии нужного глифа подставляют другой шрифт. Сравните исходный текст, кодовые точки и результат в целевой программе.
Достаточно ли проверить символы в таблице глифов?
Нет. Таблица помогает заметить отсутствие знака и оценить его форму отдельно, но не показывает поведение в слове, мелком кегле и межстрочном интервале. Используйте сочетание изолированной пробы, тестовых слов и абзаца.
Нужно ли включать U+0326 в тест?
Да, если шрифт будет использоваться с текстом, в котором буквы записаны разложенной последовательностью. U+0326 — COMBINING COMMA BELOW; его нужно проверить вместе с базовыми s и t. Для заранее нормализованного текста готовых букв может быть достаточно, но проверка помогает выявить проблемы импорта.
Можно ли заменить все румынские Ș/Ț на Ş/Ţ в старом документе?
Не вслепую. Unicode отмечает, что старые данные иногда использовали форму с седилью для румынской запятой снизу, но те же символы применяются в других языках. Определите язык и происхождение файла до пакетной замены, а оригинал сохраните.
Как сделать личный шрифт пригодным для румынского текста?
Подготовьте список нужных символов, нарисуйте их в одном стиле с латинской основой и проверьте обе регистровые формы в словах и строках. Затем испытайте шрифт в том приложении и формате, где его будут использовать; получить рисунок букв можно в Fontgenerator, а языковую поддержку следует проверять по фактическому набору символов.
Вывод
Для румынского текста недостаточно нарисовать небольшую отметку под S и T: нужно различать запятую снизу и седиль, проверить четыре кодовые точки и убедиться, что готовые и разложенные варианты читаются в рабочем макете. Сохраните короткий тестовый набор вместе с проектом и повторяйте его после каждой версии шрифта. Это занимает мало времени и помогает обнаружить замену, обрезку или неверную форму до публикации.